パルワールドのサーバーを24時間動かし続ける:自動起動・自動再起動・定時再起動
パルワールドのサーバーを24時間動かし続けるには、性質の違う三つが揃っている必要があります。起動時の自動実行、落ちたときの自動復帰、毎日の定時再起動。systemd ユニットがどこまで面倒を見てどこから見ないのか、落ちたことにどう気づくかまで。
「24時間動かしっぱなしにする」は設定一つではなく、性質の違う三つの仕組みです。起動時に勝手に立ち上がること、落ちたときに立ち上がり直すこと、そしてまだ落ちていないうちに自分から止めて起こし直すこと。三つのうち一つを抜かすと、抜かしたその一点でぴたりと止まります。サーバーをまだ作っていないなら専用サーバーの立て方を先にどうぞ。この記事は、すでに動いているサーバーを動かし続ける話です。
常時起動が意味する三つのこと
止まり方は三通りあり、それぞれ別の仕組みが受け持ちます。
| 止まる場面 | 必要なもの | どこで設定するか |
|---|---|---|
| カーネルのアップデートや停電のあとマシンが再起動した | 起動時の自動実行 | systemd の enable |
| メモリ不足でプロセスが殺された、エンジンがクラッシュした | 落ちたときの自動復帰 | ユニットの Restart |
| 何も死んでいないのにどんどん重くなる | 毎日の定時再起動 | タイマーまたは cron |
三つは互いの代わりになりません。Restart=on-failure は起動時の自動実行とは何の関係もなく(それは enable の仕事です)、enable は一時間前に死んだプロセスを生き返らせてくれず、どちらもメモリが埋まっていく間は何もしません。「自動再起動を入れてあるのになぜ落ちているのか」は、たいてい入れていない残りの一つから出てきます。
そして人の手が要る四つ目があります。止まったことに気づくことです。三つ全部を入れても三つとも外れる夜は来るので、最後は誰がどれだけ早く気づくかが残ります。
systemd ユニットが見てくれる範囲と、その外側
ユニットファイルは専用サーバーの立て方のものに、[Unit] セクションへ二行足して使います。この記事に関わるのは次の行です。
[Unit]
StartLimitIntervalSec=600
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=10

[Install]
WantedBy=multi-user.target
WantedBy=multi-user.target と sudo systemctl enable palworld の組み合わせが起動時の自動実行です。立て方に出てくる enable --now の --now は「ついでに今も起動する」という意味しかないので、enable を飛ばして start だけしていると、今は元気に動いていて次の再起動で消えます。これは頭の中では確かめられない種類の失敗なので、誰もいない時間に一度は本当に sudo reboot して、勝手に戻ってくるかを見てください。
Restart=on-failure が面倒を見てくれるのは、0以外の終了コードと、シグナルで死んだ場合です。メモリを使い切ってカーネルにプロセスを殺されるのは後者に入ります。
見てくれないのは次の三つです。
- 正常終了(コード0)。 REST API 経由で落としたサーバーはきれいに終わるので、
on-failureはあえて手を出しません。「スクリプトが止めたところまではいいのに起動し直してくれない」の九割はこれです。 - 生きているのに応答しない状態。 systemd が見ているのはプロセスであってゲームではありません。入れるけれど誰も動けない状況でも、ユニットから見れば
activeのままです。 - 繰り返す失敗。
StartLimitの二行があると、10分のあいだに5回起動に失敗した時点で systemd は諦め、failedで止まります。systemd 自体の既定は「10秒のあいだに5回」で、RestartSec=10で毎回10秒待つユニットでは決して届きません。二行がなければ、毎回同じ理由で死ぬサーバーはactivating (auto-restart)のまま延々と再試行を続けます。systemctl status palworldに「start request repeated too quickly」が出ていたら、自動復帰が壊れているのではなく、毎回同じ理由で死んでいるからログを見ろという意味です。
三つ目を、この二行を消したり StartLimitIntervalSec=0 にしたりして塗りつぶさないでください。壊れたセーブを読めずに起動できないサーバーが10秒おきに永遠に再試行するだけで、そのあいだに本当の原因は何千行も下へ流れていきます。journalctl -u palworld -n 100 で最後の失敗理由を読むほうが、いつでも速いです。
毎日の定時再起動は選択肢ではない
Restart=on-failure が動くのはプロセスが死んだあとですが、メモリが増える一方のパルワールドのサーバーでいちばんつらいのは、全員が重くなる死ぬ前の時間で、定時再起動はそこを一日一回切り落とす別の仕組みです。なぜメモリが増えるのか、どのくらいの間隔で回すべきかはメモリリークと定時再起動に、同じ停止にアップデートの確認を組み込む方法はパルワールド専用サーバーのアップデート方法にあります。
仕掛けるだけなら cron がいちばん短く、そのスクリプトはメモリリークの記事にそのままあります。systemd で揃えたいならタイマーでも書けます。
# /etc/systemd/system/palworld-restart.timer
[Unit]
Description=Restart Palworld daily

[Timer]
OnCalendar=*-*-* 04:00:00

[Install]
WantedBy=timers.target
同じ名前の palworld-restart.service(Type=oneshot)が実際のスクリプトを呼び、sudo systemctl enable --now palworld-restart.timer で有効になります。次の実行時刻は systemctl list-timers で確認できます。Persistent=true は入れないでください。 マシンが止まっていて逃した実行を起動直後に埋め合わせるオプションですが、二分前に立ち上がったばかりのサーバーを再起動する理由はありません。
時刻は誰もいない時間帯にして、バックアップが走る時刻と重ならないようにだけ気をつけます。
告知して、数えて、保存してから止める
kill や systemctl kill、あるいは電源ボタンで落とすのは、毎日クラッシュを一つ自作しているのと同じです。自動保存の間隔ぶんの進行が消え、運が悪ければ書き込みの最中に当たって Level.sav が半分だけ書かれた状態になります。半端なセーブは次の起動まで表に出てこないので、気づくのは一日あとです。
正しい止め方は四段階、告知 → カウントダウン → 強制セーブ → 停止で、すべて公式の REST API にあります(有効化と認証はREST API の使い方へ)。
PW='十分に長いパスワード'
API='http://127.0.0.1:8212/v1/api'

# 先にワールドをディスクへ書き出す
curl -s -u "admin:$PW" -X POST "$API/save"

# 告知とカウントダウンは API がやってくれる
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":60,"message":"Server is going down in 60 seconds"}'
message はチャット欄に流れて見落とされる一行ではありません。全員の画面の中央に、横帯の通知として表示されます:
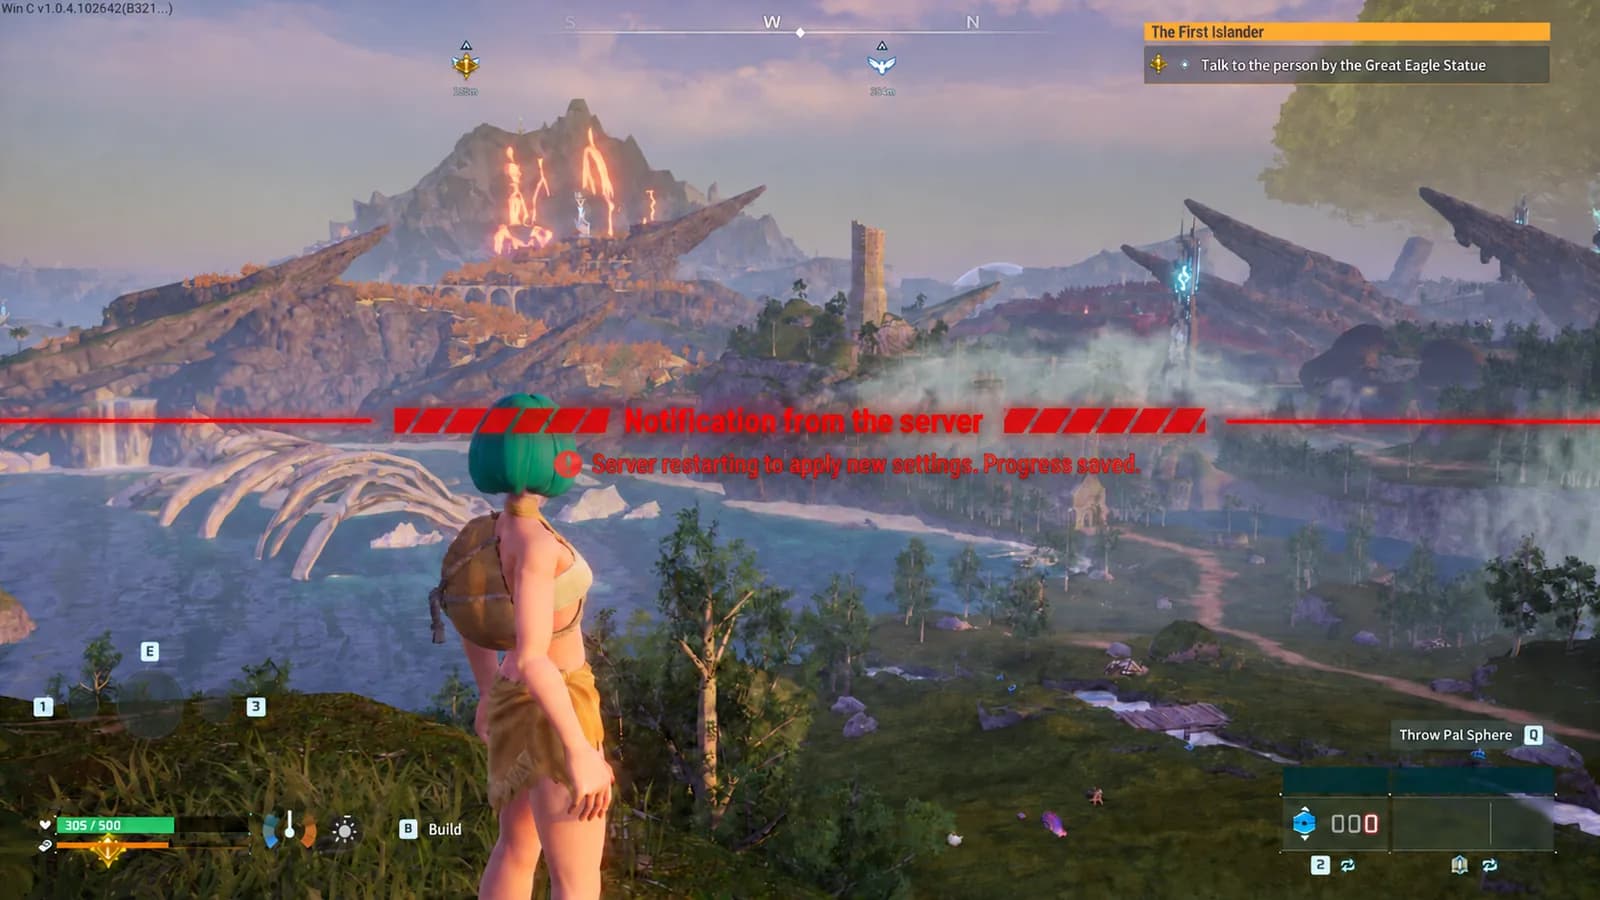
/stop は予告なしで即座に切るほうなので、日常の運用に使わないでください。/shutdown は指定した時間だけ待ってから、正しい手順で降ります。
そしてここで前の節の落とし穴がそのまま効きます。/shutdown で降りたプロセスは正常終了なので、Restart=on-failure は立ち上げ直してくれません。目的が再起動なら、API には保存と告知までをやらせて、最後の一行は sudo systemctl restart palworld に渡します。目的が本当に停止(メンテナンス、引っ越し)なら /shutdown だけで十分です。この区別をしていないサーバーが、深夜に落ちてそのまま戻ってこない事例のいちばん多い形です。
落ちたことにどうやって気づくか
既定の監視は「プレイヤーが教えてくれる」で、その通知は金曜の夜十時に五人が待っているという形で届きます。もっと安い方法が三つあります。
状態を一行で。 systemctl is-active palworld は active か failed しか返しません。理由まで見たいときは、その日のジャーナルから終了の記録だけ取り出します。
systemctl is-active palworld
journalctl -u palworld --since today | grep -i "main process exited"
ポート。 ゲームのポートは UDP 8211なので、ブラウザで開いて確かめることができません。実際に待ち受けているかは ss -lunp | grep 8211 で見ます。
1分ごとの心拍。 ローカルの cron が毎分 /metrics を叩き、失敗したら自分が実際に見る場所へ一行だけ送るようにします。cron はシェルで設定した PW を引き継がないので、パスワードは小さなスクリプトに書き、crontab の行はそのスクリプトを呼ぶだけにします。
#!/bin/bash
# /home/palserver/heartbeat.sh:cron が毎分呼ぶ
PW='十分に長いパスワード'
curl -sf -m 10 -u "admin:$PW" http://127.0.0.1:8212/v1/api/metrics >/dev/null || /home/palserver/alert.sh
-m 10 を付けておくと、生きているのに応答しないサーバーも落ちたものとして扱えます。スクリプトには管理者パスワードが入るので、chmod 700 /home/palserver/heartbeat.sh で自分以外が読めないようにしてから cron に載せます。
* * * * * /home/palserver/heartbeat.sh
外部の死活監視サービスに任せたいからといって8212をインターネットに開けるのはやめてください。開発元がインターネットに向ける設計ではないと明言しているポートで、監視と引き換えにサーバーの管理権限を丸ごと渡す取引になります。心拍はマシンの中で回し、外に出るのは通知の一行だけにします。
自宅のマシンには越えられない壁が二つある
停電。 一度落ちればそれは kill -9 一回で、セーブ書き込み中に当たる可能性もあります。UPS が買えるのは数分で、その数分は「電源が切れたら順番に降りる」ことに使ってはじめて意味を持ちます。つまり UPS の監視デーモンが停電を検知したときに、上の停止スクリプトを呼ぶところまで繋いで完成です。電気が戻ったあとマシンが自分で起動するかどうかも OS の設定ではなく、BIOS の電源復帰の項目で決まります。再起動の確認と同じで、これも一度は本当にコンセントを抜いて確かめないと確かめたことになりません。
動的 IP。 家庭用回線のグローバル IP は予告なく変わり、変わった瞬間に友達が保存している アドレス:ポート はすべて死んだアドレスになります。DDNS でホスト名を追従させることはできますが、パルワールドのクライアントに残るのは入力した文字列なので、結局一度は全員が入れ直します。これにルーターの再起動、上りの帯域、回線事業者側のアドレス共有が重なると切り分けが長くなるので、その順番は接続トラブルの切り分けにまとめてあります。
どちらも設定を工夫して越える種類の問題ではありません。自宅のマシンで数日持たせるのは普通にできますが、無人で数か月持たせようとすると、この二つが毎回立ちはだかります。
よくある質問
パルワールドのサーバーを24時間動かし続けるにはどうすればいいですか?
三つを別々に用意します。systemd ユニットを enable して起動時の自動実行にすること、ユニットに Restart=on-failure を入れて落ちたときの自動復帰を作ること、タイマーか cron で一日一回の定時再起動を仕掛けること。どれか一つだけでは、残り二つの場面でそのまま止まったままになります。
サーバーが落ちた(鯖落ち)ときに自動で再起動させられますか?
できます。ユニットの [Service] に Restart=on-failure と RestartSec=10 を書けば、クラッシュやメモリ不足で死んだ10秒後に立ち上がり直します。[Unit] にも StartLimitIntervalSec=600 と StartLimitBurst=5 を入れておくと、毎回同じ理由で落ちるサーバーが延々と回り続けず、10分で5回失敗した時点で止まります。ただしこれは原因を直すのではなく時間を稼ぐ仕組みです。一日に何度も発動するなら、見るべきは再起動の設定ではなくメモリのほうです。
自動再起動を設定したのにサーバーが戻ってきません。何を見ればいいですか?
まず systemctl status palworld です。「start request repeated too quickly」なら10分のあいだに5回失敗して systemd が諦めた状態で、本当の原因はログにあります。直したら sudo systemctl reset-failed palworld で回数を戻してから起動します。状態が activating (auto-restart) から変わらないなら StartLimit の二行が抜けていて、再試行を繰り返しています。エラーもなく静かに inactive なら正常終了で、on-failure が意図して手を出さなかった場合です。その場合はスクリプトの最後の一行を systemctl restart に変えれば直ります。
自宅の PC でパルワールドのサーバーを24時間動かしても大丈夫ですか?
数日なら問題ありません。長く続けると停電と動的 IP で止まります。停電は予告なしの強制終了なのでセーブが壊れることがあり、グローバル IP が変わると全員が保存した接続先が無効になります。どちらも設定では越えられないので、常設にするなら電源と回線を別の誰かが維持しているマシンが要ります。
レンタルサーバーでは三つがどこにあるか
三つをそのまま移してみると、こうなります。
一つ目の起動時の自動実行は、そもそも作業として存在しなくなります。マシンとゲームのプロセスをまとめて預ける形なので、enable を忘れる場所がありません。二つ目、落ちたプロセスは自動で立ち上げ直されます。三つ目の毎日の定時再起動は、コンソールのマイサーバーからサーバー詳細に入ったところに、スイッチと時刻の二項目として置いてあります。静かな時間帯を指定すれば、タイマーのファイルも Persistent の判断も出てきません。
その再起動の直前に起きることも、この記事で手で書いた順番のままです。まずゲーム内にサーバーアナウンスが流れ、カウントダウンが終わってから強制セーブが入り、そのあとで降ります。そして数えていなかった四つ目、気づくことも同じページにあります。フレームレートとオンライン人数が毎分記録され、止まっていた区間は線の空白として残るので、昨夜の三時に何があったかはログを掘らずに目で確認できます。
KeepWorlds のパルワールド専用サーバーでこれらが置かれている場所が、いま書いたところです。自分で立てる道を選ぶ場合でも、確認する項目は同じ四つです。enable を一度、Restart を一行、タイマーを一つ、そして気づく手段を一つ。ここまで押さえておけば、少なくとも「なぜ止まっているのか分からない」という止まり方からは抜けられます。
逆に、そもそも誰もいない時間にワールドが動いている必要があるのか、という問いのほうだったなら、自動一時停止とその代償にまとめてあります。