팰월드 24시간 서버 만들기: 자동 실행, 자동 복구, 예약 재시작
팰월드 24시간 서버에 필요한 부팅 시 자동 실행, 꺼짐 자동 복구, 매일 재시작과 실제 서버의 메모리 추이, 자동 일시정지보다 끄는 게 나은 이유를 정리했어요.
팰월드 서버를 24시간 켜둔다는 건 설정 한 줄이 아니라 서로 다른 세 가지 장치예요. 부팅할 때 알아서 뜨는 것, 죽었을 때 다시 뜨는 것, 그리고 아직 죽지 않았는데 미리 껐다 켜는 것. 셋 중 하나를 빼놓으면 정확히 그 자리에서 끊겨요. 이 글은 그 세 가지와 함께, 계속 켜 둔 서버에서 메모리가 실제로 어떻게 움직이는지, 세이브를 잃지 않고 재시작하는 법, 그리고 반대 질문인 "아무도 없는 동안 월드가 굳이 돌아가야 하나"까지 다뤄요. 서버를 아직 안 만들었다면 구축 가이드를 먼저 보고 오세요.
서버를 24시간 열어 놓으려면 세 가지가 다 있어야 해요
"계속 켜두기"가 실패하는 방식은 세 가지고, 각각 다른 장치가 막아요.
| 끊기는 상황 | 필요한 것 | 어디서 |
|---|---|---|
| 커널 업데이트나 정전 뒤 머신이 재부팅됨 | 부팅 시 자동 실행 | systemd의 enable |
| 메모리 부족으로 프로세스가 죽거나 엔진이 크래시함 | 꺼짐 자동 복구 | 유닛의 Restart |
| 아무것도 안 죽었는데 점점 무거워짐 | 매일 예약 재시작 | 타이머 또는 cron |
세 줄이 서로를 대신하지 못해요. Restart=on-failure는 부팅과 아무 상관이 없고(그건 enable이 하는 일), enable은 죽은 프로세스를 살려 주지 않으며, 둘 다 메모리가 차오르는 동안에는 아무 일도 하지 않아요. 그 구간에는 아직 아무것도 실패하지 않았으니까요. "자동 재시작 해 놨는데 왜 꺼져 있냐"는 대부분 셋 중 안 해 둔 하나에서 나와요.
여기에 사람 손이 필요한 네 번째가 하나 더 있어요. 끊긴 걸 알아채는 것. 앞의 셋을 다 해 둬도 세 개가 동시에 실패하는 날은 오고, 그날 누가 먼저, 얼마나 늦게 아느냐가 남아요.
systemd 유닛이 막아 주는 것과 막지 못하는 것
유닛 파일은 구축 가이드에 있는 것에 [Unit] 섹션 두 줄만 더하면 돼요. 여기서 볼 줄은 이것들이에요.
[Unit]
StartLimitIntervalSec=600
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=10

[Install]
WantedBy=multi-user.target
WantedBy=multi-user.target과 sudo systemctl enable palworld가 짝이 되어 부팅 시 자동 실행을 만들어요. 가이드에 나오는 enable --now에서 --now는 "지금도 켜라"는 뜻일 뿐이에요. enable 없이 start만 해 두면 지금은 잘 돌아가는데 재부팅하면 안 올라와요. 그리고 이건 머릿속으로 확인이 안 되는 종류라, 사람이 없는 시간에 한 번은 진짜로 sudo reboot을 해서 저절로 올라오는지 봐야 해요.
Restart=on-failure가 막아 주는 것은 0이 아닌 종료 코드, 그리고 시그널로 죽은 경우예요. 메모리가 꽉 차서 커널이 프로세스를 죽이는 경우도 여기 들어가요.
막지 못하는 것은 셋이에요.
- 정상 종료(코드 0). REST API로 내린 서버는 깨끗하게 끝나기 때문에
on-failure가 손대지 않아요. 스크립트로 재시작을 돌리는데 서버가 안 올라온다면 열에 아홉은 이거예요. - 프로세스는 살아 있는데 응답이 없는 상태. systemd가 보는 건 프로세스지 게임이 아니에요. 접속은 되는데 아무도 못 움직이는 상황에서 유닛은 여전히
active예요. - 반복되는 실패.
StartLimit두 줄을 넣어 두면 10분 안에 5번 시작에 실패했을 때 systemd가 포기하고failed로 남아요. systemd 자체 기본값은 "10초 안에 5번"이라,RestartSec=10으로 매번 10초씩 기다리는 유닛은 절대 그 조건에 걸리지 않아요. 두 줄이 없으면 매번 같은 이유로 죽는 서버는activating (auto-restart)상태로 끝없이 재시도해요.systemctl status palworld에 "start request repeated too quickly"가 보이면 자동 복구가 고장 난 게 아니라, 매번 같은 이유로 죽고 있으니 로그부터 보라는 뜻이에요.
두 줄을 지우거나 StartLimitIntervalSec=0으로 꺼서 이 세 번째 경우를 덮어 버리지 마세요. 세이브가 깨져서 못 뜨는 서버를 10초마다 영원히 재시도하게 될 뿐이고, 그동안 진짜 원인은 로그 수천 줄 아래로 밀려나요. journalctl -u palworld -n 100으로 마지막 실패 이유를 먼저 읽는 게 언제나 빨라요.
계속 켜 둔 서버에서 메모리는 어떻게 움직이나
팰월드 서버는 얼리 액세스 시절에 "프로세스가 죽을 때까지 메모리가 오른다"는 평판을 얻었고, 재시작에 관한 조언 대부분은 아직도 그걸 전제로 해요. 아래는 저희가 운영하는 서버 중 접속이 많은 편인 한 대가 실제로 보인 값이에요. 하루 한 번 재시작하는 서버이고, 2026년 10월 열흘 동안 모니터링에 찍힌 메모리 사용량이에요.
| 매일 재시작 직후 최저 | 그날의 최고점 | |
|---|---|---|
| 열흘 동안의 범위 | 2.4–3.0 GB | 3.3–4.5 GB |
여기서 어떤 경험칙보다 쓸모 있는 게 두 가지예요.
- 사람이 플레이하는 동안 오르고, 안 하면 멈춰요. 보통 하루면 재시작 사이에 0.5–1.5 GB가 늘었어요. 조용한 날에는 선이 3.2 GB 근처에서 몇 시간이고 평평했어요.
- 하루 최고점이 날마다 조금씩 올라가지 않았어요. 재시작할 때마다 같은 바닥으로 돌아갔어요.
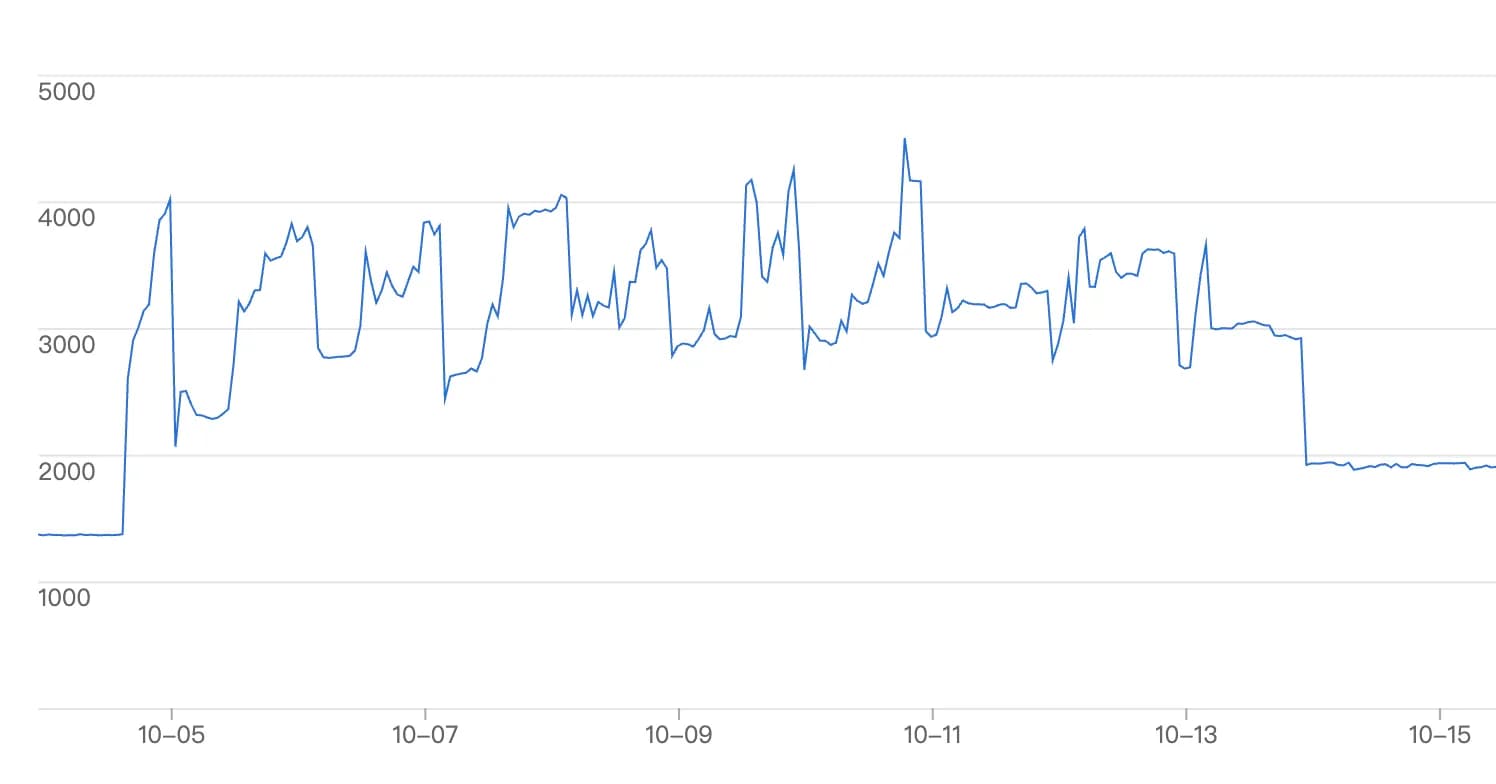
이 숫자로 알 수 없는 건 재시작을 아예 안 하면 어떻게 되느냐예요. 저희가 운영하는 서버는 전부 매일 재시작하거든요. 내 월드에서 메모리가 계속 오르는지는 짐작하지 말고 재 봐야 해요. 어느 쪽이든 매일 재시작은 싼 보험이에요. 밤마다 바닥을 원래대로 돌려놓고, 저장과 업데이트에 정해진 시점을 만들어 주니까요.
메모리는 어디로 가나
팰월드 서버의 메모리는 세 덩어리로 나뉘고, 각각 다른 질문에 답해요.
- 기본 점유. 서버가 뜬 순간부터 잡고 있는 몫이고, 1.0 이후로 더 커졌어요. 해상 거점은 헤엄치는 팰과 나는 팰의 경로 탐색을 더했고, 하늘섬과 세계수는 추가 로딩 구역이에요. 이게 바닥이에요.
- 접속 중인 플레이어. 시야 로딩과 탐색 범위 몫이에요. 나가면 일부는 반환되지만 전부는 아니에요.
- 월드에 쌓인 것들. 거점, 건축물, 일하는 팰, 바닥의 드롭 아이템. 플레이어가 나가도 전부 계속 시뮬레이션돼요. 월드가 오래될수록 커지는 몫이 이거예요. 그만둔 사람이 거점을 가져가진 않으니까요.
앞의 둘은 저녁 시간 꽉 찬 서버에 램이 얼마나 필요한지를 정하고, 셋째와 엔진이 돌려주지 않는 나머지가 재시작을 얼마나 자주 할 만한지를 정해요.
내 서버에서 직접 확인하기
| 신호 | 확인 방법 |
|---|---|
| 재시작 직전의 메모리, 머신 한계와 비교 | top / htop에서 서버 프로세스의 RES를 봐요. Windows는 작업 관리자 |
| 가동 시간이 길수록 렉이 심해지고 재시작하면 사라진다 | 재시작 자체가 테스트예요. 재시작 후 나아지면 쌓인 부하, 그대로면 머신이 작거나 회선 문제 |
| 프로세스가 사라지고 전원이 동시에 튕긴다 | Linux라면 dmesg에 커널이 메모리 부족으로 프로세스를 죽인 기록이 남아요 |
재시작해도 아무것도 안 바뀌면 다른 데를 보세요. 머신이 애초에 부족했거나, 다들 느끼는 게 서버가 아니라 회선 쪽이에요. 누가 느끼는지부터 서버 자체의 프레임률까지 순서대로 가르는 방법은 서버 렉, 원인부터 가려내는 순서에 있어요.
마지막 줄이 가장 아픈 경우예요. 커널이 죽이는 순간에 세이브를 쓰고 있었을 수 있고, 반쯤 쓰다 만 Level.sav는 다음 시작 때에야 드러나요. 메모리와 백업을 같은 이야기로 봐야 하는 이유예요.
메모리 점유량을 바꾸는 설정
전부 PalWorldSettings.ini의 그 한 줄 안에 있어요(안전한 편집법은 설정 전체 해설에).
| 설정 | 기본값 | 권장 | 이유 |
|---|---|---|---|
bEnableInvaderEnemy | True | 습격이 아쉽지 않다면 False | 거점 습격은 AI 개체와 경로 탐색을 한꺼번에 대량으로 만들어 내고, 대개 아무도 접속해 있지 않을 때 일어나요. 끄면 스크립트로 발생하는 습격만 사라지고 야생 팰, PvP, 보스는 그대로예요 |
BaseCampWorkerMaxNum | 15 | 기본값 유지 | 일하는 팰 한 마리마다 행동 시뮬레이션이 돌아요. 거점이 많은 서버에서 50으로 올리는 건 코어 하나를 꽉 채우는 지름길이에요 |
DropItemAliveMaxHours | 1.0 | 0.5 | 주인 없는 드롭 아이템이 남는 시간(시간 단위). 절반으로 줄이면 개체 회수가 빨라져요 |
AutoSaveSpan | 30 | 기본값 유지, 늘려도 60까지 | 자동 저장 간격이고 단위는 초예요. 짧을수록 디스크 쓰기가 잦아져서 느린 디스크에선 저장할 때마다 멈칫해요. 크래시 때 잃는 진행이 딱 이 간격만큼이라 60을 넘기진 마세요 |
반대로 하지 말아야 할 것도 있어요.
bIsUseBackupSaveData를 끄지 마세요. 메모리를 먹는 항목이 아니라, 뭔가 깨진 날 돌아갈 길이에요.ServerReplicatePawnCullDistance를 5000 아래로 내리지 마세요. 공식 하한이고, 그 아래로 내리면 플레이어에게 멈춰 있는 팰이 보여요.- 한 머신에서 팰월드 서버 둘을 돌리지 마세요.
얼마나 자주 재시작할까
사양표에서 읽어 낼 수 있는 간격은 없어요. 내 월드가 여유를 얼마나 빨리 먹는지에 달렸고, 그건 얼마나 지었는지, 습격을 켰는지, 하루 종일 누군가 접속해 있는지로 정해져요. 하루 한 번에서 시작하고, 직접 잰 값을 보고 조정하세요.
| 재시작 직전 남은 여유 | 할 일 |
|---|---|
| 넉넉하게 남아 있다 | 조용한 시간에 하루 한 번이면 충분해요 |
| 5분의 1 아래 | 습격부터 끄고, 그다음 간격을 줄이거나 램을 늘려요 |
| 재시작 사이에 프로세스가 죽었다 | 바로 간격을 줄이고, 마지막 세이브가 열리는지 확인해요 |
고정 멤버 서버라면 실용적인 답은 아무도 안 하는 시간에 하루 한 번이에요. 하루 종일 누군가 있는 공개 서버라면 그보다 자주 필요할 수 있어요.
그냥 죽이지 말고 공지, 카운트다운, 강제 저장 순서로
kill이나 systemctl kill, 전원 버튼으로 내리는 건 매일 크래시를 하나씩 만드는 것과 같아요. 자동 저장 간격만큼의 진행이 사라지고, 운이 나쁘면 저장 중에 맞아서 Level.sav가 반만 써져요. 반만 써진 세이브는 다음 시작 때에야 드러나요.
정상 종료의 순서는 공지 → 카운트다운 → 강제 저장 → 정지예요. 네 단계 전부 공식 REST API에 있어요. 먼저 PalWorldSettings.ini에서 API를 켜고, 로컬호스트에만 열어요.
RESTAPIEnabled=True
RESTAPIPort=8212
AdminPassword="충분히 긴 비밀번호"
인증은 HTTP Basic이고 사용자 이름은 항상 admin, 비밀번호는 AdminPassword예요. 개발사는 공식 문서에서 이 API가 인터넷에 직접 노출되도록 설계되지 않았다고 명시했으니 방화벽에서 8212를 열지 마세요. RCON은 지원이 중단됐으니 새 스크립트의 바탕으로 삼지 말고요. 엔드포인트 전체 목록은 REST API 사용법에 있어요.
PW='충분히 긴 비밀번호'
API='http://127.0.0.1:8212/v1/api'

# 저장을 먼저 확실히 해 두고
curl -s -u "admin:$PW" -X POST "$API/save" -d ''

# 공지와 60초 카운트다운은 API가 대신 해 줘요
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":60,"message":"Server is going down in 60 seconds"}'
message는 채팅창에 올라왔다 금방 밀려나는 한 줄이 아니에요. 모든 플레이어 화면 한가운데에 배너로 떠요.
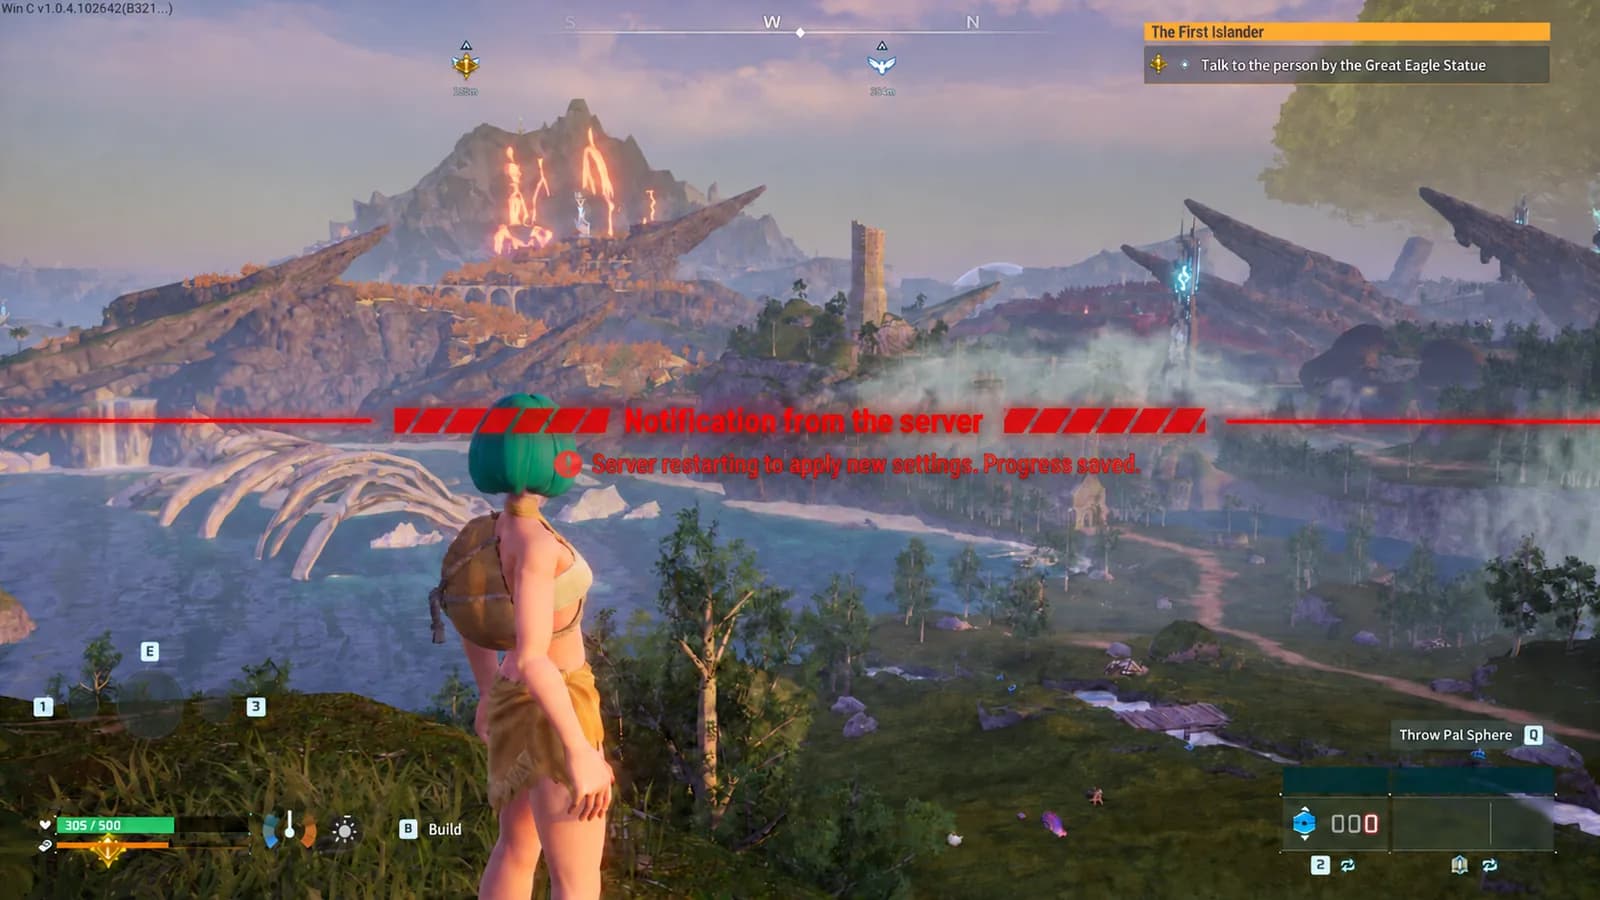
/stop은 예고 없이 즉시 끊는 쪽이니 정기 운영에는 쓰지 마세요. /shutdown은 지정한 시간을 기다렸다가 제대로 내려가요. 저장을 종료보다 먼저 두는 건 공식 문서가 종료 시 저장 여부를 명시하지 않기 때문이에요.
그리고 여기서 systemd 절의 함정이 그대로 걸려요. /shutdown으로 내려간 프로세스는 정상 종료라서 Restart=on-failure가 다시 띄워 주지 않아요. 목적이 재시작이라면 API로는 저장과 공지까지만 하고, 마지막 한 줄은 sudo systemctl restart palworld로 넘기세요. 목적이 진짜 정지(점검, 서버 이전, 아무도 안 하는 한 주)라면 /shutdown으로 충분해요. 이 구분을 안 해서 "새벽에 꺼지고 안 켜지는" 서버가 가장 흔해요.
매일 예약 재시작을 스크립트 하나로
#!/bin/bash
# /home/palserver/restart.sh: 공지, 저장, 재시작
PW='충분히 긴 비밀번호'
API='http://127.0.0.1:8212/v1/api'

curl -s -u "admin:$PW" -X POST "$API/announce" \
     -H 'Content-Type: application/json' \
     -d '{"message":"Server restarts in 5 minutes for maintenance"}'
sleep 240
curl -s -u "admin:$PW" -X POST "$API/announce" \
     -H 'Content-Type: application/json' \
     -d '{"message":"Saving and restarting in 60 seconds"}'
sleep 60
curl -s -u "admin:$PW" -X POST "$API/save" -d ''
sleep 10
sudo systemctl restart palworld
스크립트에 관리자 비밀번호가 들어 있으니 chmod 700으로 본인만 읽게 해 두세요. cron에 걸어 매일 새벽 네 시에 돌려요.
0 4 * * * /home/palserver/restart.sh >> /home/palserver/restart.log 2>&1
systemd만 쓰고 싶다면 타이머로도 돼요.
# /etc/systemd/system/palworld-restart.timer
[Unit]
Description=Restart Palworld daily

[Timer]
OnCalendar=*-*-* 04:00:00

[Install]
WantedBy=timers.target
같은 이름의 palworld-restart.service(Type=oneshot)가 위 스크립트를 부르고, sudo systemctl enable --now palworld-restart.timer로 켜요. 다음 실행 시각은 systemctl list-timers로 확인해요. Persistent=true는 넣지 마세요. 머신이 꺼져 있어서 지나간 실행을 부팅 직후에 따라잡는 옵션인데, 방금 켜진 서버를 곧바로 다시 재시작할 이유는 없어요. 시각은 사람이 없는 시간으로 잡고, 백업이 도는 시각과 겹치지 않게만 신경 쓰면 돼요.
Windows도 같은 방식이에요. PowerShell의 Invoke-RestMethod로 announce와 save를 차례로 부르고, Stop-Process로 PalServer-Win64-Shipping을 멈춘 뒤 PalServer.exe를 다시 띄우고, 작업 스케줄러에 매일 실행으로 걸어 두면 돼요.
어차피 하루에 한 번 멈추니까, 그 재시작이 새 게임 버전을 확인하기에 가장 싼 자리예요. 버전 확인을 얹는 법, 그 앞에 반드시 둬야 하는 백업, 새 빌드에서 월드가 안 열릴 때의 대처는 팰월드 서버 업데이트 방법에 정리해 뒀어요.
서버가 꺼진 걸 알아채는 가장 싼 방법
기본값은 "플레이어가 알려 준다"인데, 이 알림은 금요일 밤 열 시에 다섯 명이 기다리는 형태로 도착해요. 더 싼 방법이 세 가지 있어요.
상태 한 줄. systemctl is-active palworld는 active나 failed만 뱉어요. 이유까지 보려면 오늘 로그에서 종료 기록만 뽑아요.
systemctl is-active palworld
journalctl -u palworld --since today | grep -i "main process exited"
포트. 게임 포트는 UDP 8211이라 브라우저로 열어 볼 수가 없어요. 실제로 포트를 열고 대기 중인지는 ss -lunp | grep 8211로 봐요.
1분 심박. 로컬 cron이 1분마다 /metrics를 찔러 보고, 실패하면 내가 실제로 보는 곳으로 한 줄 보내게 하세요. cron은 셸에서 정한 PW를 물려받지 않으니, 비밀번호는 작은 스크립트에 적고 crontab 줄은 그 스크립트만 부르게 해요.
#!/bin/bash
# /home/palserver/heartbeat.sh: cron이 1분마다 불러요
PW='충분히 긴 비밀번호'
curl -sf -m 10 -u "admin:$PW" http://127.0.0.1:8212/v1/api/metrics >/dev/null || /home/palserver/alert.sh
-m 10을 붙여 두면 살아 있는데 응답이 없는 서버도 꺼진 것으로 잡혀요. 이 스크립트도 chmod 700 /home/palserver/heartbeat.sh로 본인만 읽게 한 뒤 cron에 걸어요.
* * * * * /home/palserver/heartbeat.sh
외부 감시 서비스에 맡기려고 8212를 공개 인터넷에 여는 건 하지 마세요. 감시를 얻는 대신 서버 관리 권한 전체를 내놓는 거래가 돼요. 심박은 머신 안에서 돌리고, 나가는 건 알림 한 줄만 나가면 돼요.
자동 일시정지가 가리키는 두 가지
반대 질문이 나올 때도 있어요. 하루 만에 접속했더니 팰 절반은 배가 고프고 둘은 병이 났고, 상자에는 아무도 시키지 않은 광석이 가득해요. 그동안 아무도 접속하지 않았는데 월드만 계속 돌아간 거예요. 전용 서버(데디 서버)는 마지막 사람이 나갔다고 쉬지 않고, 만원일 때와 똑같은 주기로 월드를 계산해요. 아무 때나 들어올 수 있는 이유가 그거고, 아무도 안 들어오는 시간에도 똑같이 나이를 먹는 이유도 그거예요. 게임 안에서 여는 방식(한 명이 월드를 열고 나머지가 붙는 방식)은 여는 사람이 종료하면 월드도 멈추니까, 그쪽에서 하다 온 팀이라면 여기서 습관이 어긋나요(두 방식이 월드를 각각 어디에 두는지).
이럴 때 추천받는 게 자동 일시정지인데, 이 말은 서로 다른 두 기능을 가리켜요. 요금을 멈추는 쪽은 접속자가 없는 구간을 과금하지 않는 방식이에요. 월드도 대개 같이 멈추지만 이 기능이 내세우는 건 가격이에요. 월드를 멈추는 쪽은 게임 속 시간이 더 이상 흐르지 않는 거예요. 팰이 먹지 않고 작물이 자라지 않고, 습격도 오지 않아요. 어느 쪽을 파는 건지는 두 가지만 물어보면 갈려요. 일시정지 중에 월드가 흘러가나요, 그리고 다시 플레이할 수 있기까지 얼마나 걸리나요.
자동 일시정지는 실제로 어떻게 동작하나
시중의 자동 일시정지 대부분은 운영체제 시그널 두 개로 프로세스를 얼려요.
kill -STOP <pid>   # 그 자리에서 얼림
kill -CONT <pid>   # 하던 자리부터 다시
SIGSTOP은 팰월드 명령이 아니고, 게임은 이런 일이 있었다는 것조차 몰라요. 커널이 그 프로세스에 CPU를 더 주지 않을 뿐이에요. 메모리도 열어 둔 파일도 UDP 포트도 그대로 쥐고 있고, SIGCONT를 받으면 얼어붙은 바로 그 명령어부터 이어서 실행해요.
| 얼린 상태 | 중지 | 실행 중 | |
|---|---|---|---|
| 프로세스 | 있음, 실행만 안 함 | 없음 | 실행 |
| 메모리 | 그대로 점유 | 반납 | 점유 |
| 월드 시간 | 멈춤 | 멈춤 | 흐름 |
| 복귀 | 몇 초 | 서버 시작 + 월드 로딩 | — |
이 두 줄을 안전하게 쓰려면 주변에 세 가지를 더 만들어야 해요. 얼리기 전에 강제 저장. SIGSTOP은 가로챌 수 없어서, 디스크에 안 내려간 건 메모리에 그대로 남고 그 상태에서 전원이 나가면 그만큼이 사라져요. 누군가 네트워크를 지켜봐야 해요. 얼어 있는 프로세스는 사람이 온 걸 알 수 없으니, 별도의 무언가가 root로 돌면서 들어오는 패킷을 엿보다가 SIGCONT를 보내 줘야 해요. 목록에 남아 있게 해 줘야 해요. 서버가 게임사 백엔드로 보내던 신호도 같이 멈추니까, 다른 무언가가 그 서버인 척해 주지 않으면 얼린 서버는 커뮤니티 서버 목록에서 사라져요.
이 중 어느 것도 게임사가 제공하는 기능이 아니에요. 공식 REST API에는 /save, /shutdown, /stop, /announce, 추방과 차단이 있고 일시정지는 없어요. 집에 둔 기기라면 합리적인 거래예요. 거기서는 전기요금이 목적이니까요. 하지만 남이 운영해 주는 서버에서는, 다른 방법으로도 얻을 수 있는 결과를 위해 움직이는 부품 세 개를 같이 사는 셈이에요.
더 단순한 방법: 그냥 끄기
"일시정지"로 사람들이 원하는 건 거의 언제나 우리가 안 할 때 월드도 안 돌아갔으면이에요. 서버를 끄면 그게 그대로 돼요. 월드는 디스크로 내려가고, 실행되는 게 없으니 게임 속 시간도 흐를 수가 없고, 다시 켜면 그 세이브에서 이어서 시작해요. 안전하게 끄는 순서는 위에서 본 저장 다음 /shutdown 짝 그대로예요. 솔직히 말하면 대가는, 다시 올라오는 데 1초가 아니라 서버 시작과 월드 로딩만큼 걸린다는 거예요. 저녁에 모여서 하는 팀이면 먼저 온 사람이 켜면 돼요.
끄는 쪽을 자동화하기
알아서 돌게 하고 싶다면 자동화할 부분은 끄는 쪽이지 얼리는 쪽이 아니에요. 5분마다 서버에 몇 명 있는지 물어보는 타이머면 돼요.
#!/bin/bash
set -o pipefail
PW='충분히 긴 비밀번호'
API='http://127.0.0.1:8212/v1/api'
STATE=/var/lib/palworld-empty-rounds
MAX=6   # 6회 x 5분 = 30분 무인

n=$(curl -sf -u "admin:$PW" "$API/metrics" | jq -r '.currentplayernum') || exit 0
case "$n" in ''|*[!0-9]*) exit 0 ;; esac   # 숫자가 아니면 아무것도 하지 않음
[ "$n" -gt 0 ] && { rm -f "$STATE"; exit 0; }

rounds=$(( $(cat "$STATE" 2>/dev/null || echo 0) + 1 ))
echo "$rounds" > "$STATE"
[ "$rounds" -lt "$MAX" ] && exit 0

curl -s -u "admin:$PW" -X POST "$API/save" -d ''
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":10,"message":"접속자가 없어 서버를 내립니다"}'
rm -f "$STATE"
함정은 처음 두 검사에 있어요. 조회 실패는 빈 서버가 아니에요. 그런데 파이프는 curl이 아니라 jq의 종료 코드를 돌려주고, jq는 죽은 엔드포인트에 null이라고 답하고는 멀쩡히 끝나요. pipefail과 숫자 검사가 없으면 그 null이 "0보다 크지 않다"가 되고, 포트가 잠깐 응답을 놓쳤다는 이유로 열 명 있는 서버가 내려가요. 카운터를 파일에 둔 건 재부팅이 세다 만 카운트를 남기지 않게 하려는 거예요.
어려운 절반은 다시 켜는 쪽이에요. 여기 있는 어떤 것도 서버를 다시 띄우지 못해요. 꺼진 머신에는 요청을 받아 줄 게 없으니까요. 끄는 건 cron 한 줄이고 켜는 건 누군가의 판단이에요. 얼리는 방식이 존재하는 이유가 바로 이 비대칭이에요.
둘 다 필요 없을 수도 있어요
거슬리는 게 "월드가 돌아간 것" 전체가 아니라 그중 일부라면, 설정 파일에서 바로 건드릴 수 있어요. 일시정지와 달리 이건 플레이하는 동안에도 적용돼요. PalStomachDecreaceRate는 팰이 배고파지는 속도를 늦추고(철자가 틀린 건 게임 쪽이에요), bEnableInvaderEnemy는 아무도 못 지키는 거점에 습격이 오지 않게 하고, WorkSpeedRate는 없는 사이에 거점이 만들어 내는 양을 줄여요.
집 컴퓨터에는 넘을 수 없는 두 가지가 있어요
정전. 한 번 나가면 그건 kill -9 한 번이고, 저장 도중에 맞을 수도 있어요. UPS는 몇 분을 벌어 줄 뿐이라, 실제로 필요한 건 "전원이 끊기면 순서대로 내려가는 것"이에요. UPS 감시 데몬이 정전을 감지했을 때 위의 정지 순서를 실행하도록 연결해야 의미가 생겨요. 그리고 전기가 돌아온 뒤에 머신이 저절로 켜지는지는 운영체제가 아니라 BIOS의 전원 복구 설정에 달려 있어요. 재부팅 테스트처럼, 이것도 한 번은 정말로 전원 코드를 뽑아서 확인해야 하는 항목이에요.
유동 IP. 가정용 회선의 공인 IP는 예고 없이 바뀌고, 바뀌는 순간 친구들이 저장해 둔 주소:포트는 전부 죽은 주소가 돼요. DDNS로 도메인 하나가 따라다니게 할 수는 있지만, 팰월드 클라이언트에 남는 건 입력한 문자열이라 한 번은 다 같이 새로 입력해야 해요. 여기에 공유기 재부팅, 상향 대역폭, 통신사 쪽 주소 공유까지 겹치면 원인 찾기가 길어지는데, 그 순서는 접속 문제 해결에 정리해 뒀어요.
두 가지 다 "설정을 더 잘하면" 넘는 문제가 아니라 회선과 전기의 문제예요. 집 컴퓨터로 며칠 켜두는 건 되지만, 몇 달을 무인으로 켜두는 건 이 두 가지가 매번 걸려요.
자주 묻는 질문
팰월드 서버를 24시간 계속 켜두려면 어떻게 하나요?
세 가지를 따로 해 두면 돼요. systemd 유닛을 enable 해서 부팅 시 자동 실행되게 하고, 유닛에 Restart=on-failure를 넣어 꺼짐 자동 복구를 만들고, 타이머나 cron으로 매일 한 번 예약 재시작을 걸어요. 셋은 각각 다른 실패를 막아서, 하나만 해 두면 나머지 두 상황에서는 그대로 꺼져 있어요.
서버가 자꾸 꺼지는데 자동으로 다시 켜지게 할 수 있나요?
네. 유닛의 [Service]에 Restart=on-failure와 RestartSec=10을 넣으면 크래시나 메모리 부족으로 죽었을 때 10초 뒤에 다시 떠요. [Unit]에 StartLimitIntervalSec=600과 StartLimitBurst=5도 넣어 두면, 매번 같은 이유로 죽는 서버가 끝없이 돌지 않고 10분 안에 5번 실패한 시점에서 멈춰요. 하루에 몇 번씩 죽는다면 재시작 정책이 아니라 죽기 직전의 메모리와 로그를 보세요.
자동 재시작을 걸어놨는데 서버가 안 올라와요. 뭘 봐야 하나요?
systemctl status palworld를 먼저 보세요. "start request repeated too quickly"면 10분 안에 5번 실패해서 systemd가 포기한 거라 로그에서 진짜 원인을 찾아야 하고, 고친 뒤에는 sudo systemctl reset-failed palworld로 횟수를 초기화한 다음 시작해요. 상태가 activating (auto-restart)에서 안 바뀐다면 StartLimit 두 줄이 빠져서 재시도만 반복하는 중이에요. 아무 기록 없이 inactive면 정상 종료라 on-failure가 손대지 않은 경우예요. 그렇다면 스크립트 마지막 줄을 systemctl restart로 바꾸면 돼요.
팰월드 서버는 왜 메모리가 계속 늘어나나요?
대부분은 사람이 플레이하는 동안 월드가 들고 있는 게 늘어서예요. 플레이어가 탐색한 범위, 그리고 모두 나간 뒤에도 계속 시뮬레이션되는 거점, 일하는 팰, 드롭 아이템이에요. 저희가 운영하는 매일 재시작하는 서버에서는 보통 하루에 0.5–1.5 GB가 늘었고, 조용한 날은 평평했으며, 하루 최고점은 열흘 동안 3.3–4.5 GB 사이에서 날마다 올라가지 않았어요. 매일 재시작하면 밤마다 바닥으로 돌아가요.
팰월드 서버는 얼마나 자주 재시작해야 하나요?
조용한 시간에 하루 한 번에서 시작하면 돼요. 기준은 재시작 직전에 남은 여유이고, 5분의 1 아래면 습격부터 끄고 그다음 간격을 줄이거나 램을 늘려요.
메모리를 늘리면 서버가 안 튕기나요?
최고점에서 메모리가 모자랄 때만 그래요. 매일 재시작 직전의 메모리를 보세요. 최고점에도 여유가 있는데 서버가 튕긴다면 램을 늘려도 달라지지 않고, 원인은 로그나 dmesg에 남아 있어요. 최고점이 한계에 닿아 있다면 램 증설이 바로 답이에요.
자동 일시정지는 팰월드에 내장된 기능인가요?
아니에요. 전용 서버에는 일시정지 명령이 없고 공식 REST API에도 해당 엔드포인트가 없어요. 자동 일시정지라는 이름으로 파는 건 전부 게임 바깥에서 하는 일이에요. 운영체제 시그널로 프로세스를 얼리거나, 서버를 끄고 필요할 때 다시 켜거나 둘 중 하나예요.
서버를 멈추면 팰이 굶지 않나요?
멈춰 있는 동안은 그래요. 배고픔을 포함해 월드의 어떤 것도 진행되지 않아요. 다만 플레이하는 시간에는 아무 영향이 없어요. 돌아올 때마다 먹이 상자가 비어 있는 게 문제라면 PalStomachDecreaceRate 쪽이 아무것도 멈추지 않고 해결해요.
집 컴퓨터로 팰월드 서버를 24시간 돌려도 되나요?
며칠은 돼요. 오래 가면 정전과 유동 IP에서 막혀요. 정전은 예고 없는 강제 종료라 세이브가 깨질 수 있고, 공인 IP가 바뀌면 저장해 둔 주소가 전부 무효가 돼요. 둘 다 설정으로 넘는 문제가 아니라서, 상시 운영할 거면 전원과 회선이 따로 관리되는 머신이 필요해요.
호스팅에서는 이 셋이 각각 어디에 있나
위의 내용을 호스팅 서버에 옮겨 보면 이렇게 돼요. 부팅 시 자동 실행은 아예 신경 쓸 필요가 없어요. 머신과 게임 프로세스를 같이 맡기는 형태라 enable을 빼먹을 자리가 없어요. 튕긴 프로세스는 자동으로 다시 떠요. 매일 예약 재시작은 콘솔의 내 서버 상세 페이지에 스위치와 시각 두 칸으로 있고, 그 시각이 가까워지면 게임 안에 서버 공지를 띄우고, 카운트다운을 마치고, 강제 저장을 한 뒤에야 재시작해요. 손으로 끄고 켜는 건 같은 페이지의 버튼 하나고, 그 뒤에서도 똑같이 공지 → 저장 → 종료 순서가 돌아요. 그래서 "이번 주는 그냥 꺼 두자"가 도박이 아니라 습관이 돼요. 백업은 정해진 주기로 돌고(완전한 백업에 들어가는 것), 프레임률과 접속 인원이 1분마다 기록돼서 서버가 멈춰 있던 구간은 로그를 뒤질 필요 없이 선이 끊긴 자리로 보여요.
여기에 없는 건 자동 유휴 종료예요. 접속 인원을 지켜보다가 대신 꺼 주는 장치는 없어요. KeepWorlds의 팰월드 전용 서버에서 이 항목들이 놓인 자리가 그래요. 직접 구축하는 쪽을 택해도 확인할 목록은 똑같아요. enable 한 번, Restart 한 줄, 먼저 저장하는 매일 재시작 하나, 그리고 끊긴 걸 알아챌 수단 하나.