幻獸帕魯伺服器 24 小時不關機:開機自動啟動、當機自動重啟、定時重啟
《幻獸帕魯》伺服器 24 小時不關機:開機自動啟動、當機自動重啟、每日定時重啟,一直開著的伺服器記憶體實際怎麼走,以及沒人玩時為什麼關掉比自動暫停好。
「24 小時掛著」不是一個設定,是三套性質不同的機制:開機時自己起來、死掉時自己回來、還沒死就先停下來再起一次。三件事少做一件,就正好會在那一件上斷掉。這篇把三件都講清楚,再看一台一直開著的伺服器記憶體實際怎麼走、怎麼重啟才不掉存檔,最後是反過來的問題:沒人在的時候,世界到底有沒有必要一直跑。伺服器還沒建起來的話,先看開服教學。
24 小時不關機其實是三件事
伺服器停掉的方式有三種,每種由不同的東西擋住。
| 什麼讓它停了 | 需要什麼 | 設定在哪 |
|---|---|---|
| 核心更新或跳電之後機器重開 | 開機自動啟動 | systemd 的 enable |
| 記憶體不足被系統砍掉,或遊戲程式當機 | 當機自動重啟 | 單元裡的 Restart |
| 什麼都沒死,只是越跑越重 | 每日定時重啟 | timer 或 cron |
三者不能互相取代。Restart=on-failure 跟開機一點關係都沒有(那是 enable 的事),enable 不會把一小時前死掉的程式救回來,而記憶體慢慢爬升的那段時間裡兩者都不會動——因為那時候還沒有任何東西失敗。
還有第四件事得靠人來做:知道它掉了。三件都做齊,還是會遇到三件一起失手的那一晚,剩下的問題只是誰先發現、隔多久發現。
systemd 單元管得到什麼,管不到什麼
單元檔用開服教學裡那份,再在 [Unit] 段補兩行。這篇要看的是下面這幾行。
[Unit]
StartLimitIntervalSec=600
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=10

[Install]
WantedBy=multi-user.target
WantedBy=multi-user.target 配上 sudo systemctl enable palworld,合起來才是開機自動啟動。教學裡 enable --now 的 --now 只是「順便現在也開起來」;只做 start 沒做 enable,今天一切正常,下次重開機它就不在了。這種失敗沒辦法在腦子裡驗證,挑一個沒人上線的時間真的 sudo reboot 一次,看它會不會自己回來。
Restart=on-failure 管得到的是非零的結束代碼,以及被訊號殺掉的情況——記憶體用光被核心砍掉屬於後者。
管不到的有三種:
- 正常結束(代碼 0)。透過 REST 介面關掉的伺服器是乾淨結束的,
on-failure刻意不碰它。「重啟腳本把伺服器停了,卻沒再把它開起來」十次有九次是這個。 - 程式還活著但沒回應。systemd 看的是程式,不是遊戲。進得去卻沒人動得了的時候,單元的狀態照樣是
active。 - 反覆失敗。有了
StartLimit那兩行,10 分鐘內啟動失敗 5 次,systemd 就會放棄,停在failed。systemd 自己的預設是「10 秒內 5 次」,每次都要先等RestartSec=10的單元永遠碰不到這條線;少了那兩行,每次都死在同一個原因上的伺服器只會停在activating (auto-restart)無限重試。systemctl status palworld裡出現「start request repeated too quickly」不代表自動重啟壞了,它是在說每次都死在同一個原因上,該去看紀錄了。
別把那兩行刪掉或設成 StartLimitIntervalSec=0 來把第三種蓋過去。那只會讓一台因為存檔壞掉而起不來的伺服器每 10 秒重試到天荒地老,真正的原因被沖到幾千行以下。先用 journalctl -u palworld -n 100 讀最後一次失敗的理由,永遠比較快。
一直開著的伺服器,記憶體實際怎麼走
《幻獸帕魯》伺服器在搶先體驗時期留下了「記憶體一路爬到程式被砍掉」的名聲,現在大部分關於重啟的建議也還是照這個前提寫的。下面是我們自己在跑、比較熱鬧的一台伺服器實際的情況:每天重啟一次,2026 年 10 月的十天,數字取自監控裡的記憶體用量。
| 每日重啟後的最低點 | 當天的最高點 | |
|---|---|---|
| 十天裡的範圍 | 2.4–3.0 GB | 3.3–4.5 GB |
這張表裡有兩件事,比任何經驗法則都值得記住:
- 有人在玩它就漲,沒人玩就停。兩次重啟之間,一般的一天漲 0.5–1.5 GB;冷清的那天,線一連幾個小時平平地停在 3.2 GB 左右。
- 每天的峰值沒有一天比一天高。每次重啟都把它拉回同一個低點。
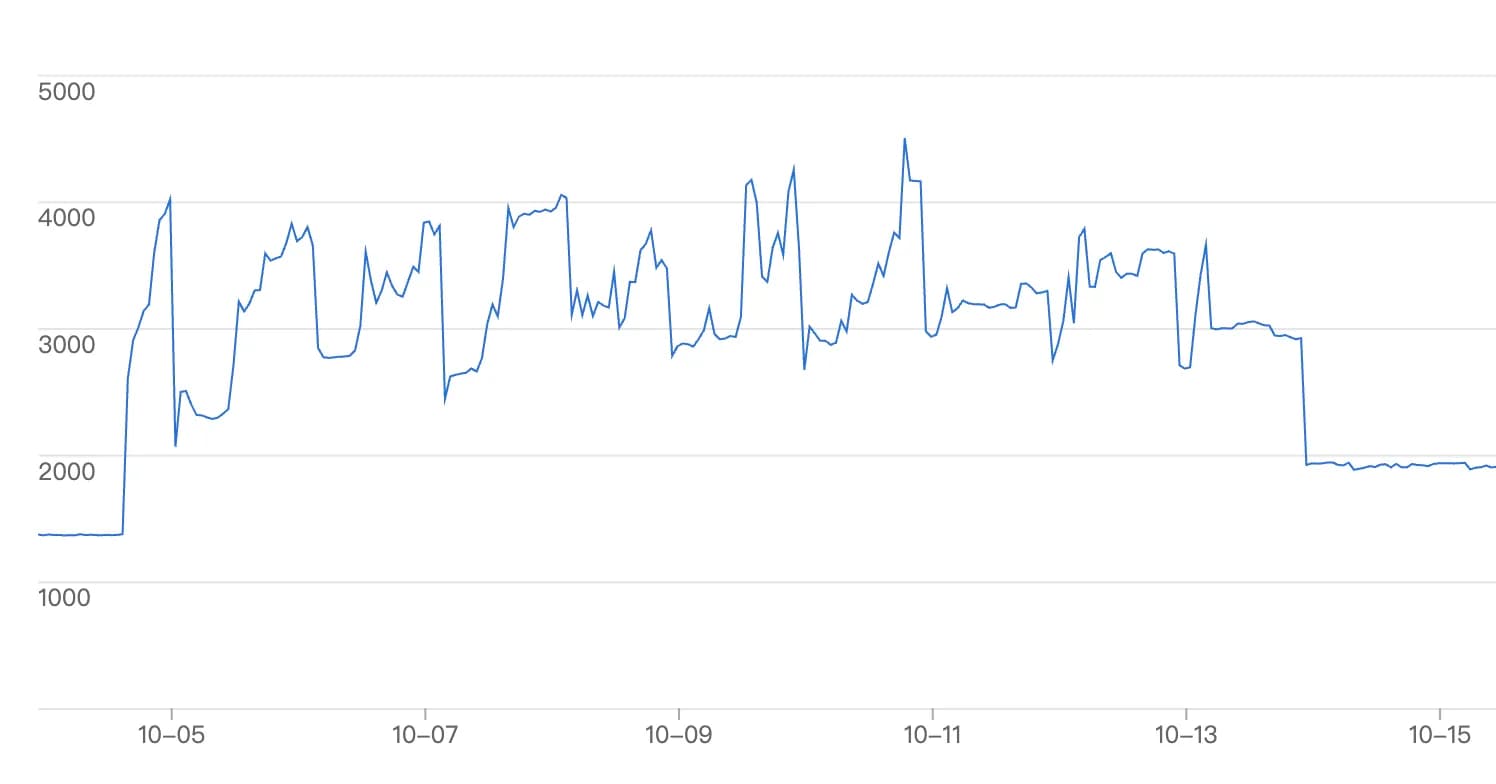
這些數字沒辦法告訴你的,是完全不重啟會怎樣,因為我們跑的每一台都每天重啟。你的世界會不會一直往上爬,要量,不要猜;而不管答案是什麼,每日重啟都是一份便宜的保險:每晚把記憶體拉回低點,也讓存檔和更新有一個固定的時間點。
記憶體去哪了
《幻獸帕魯》伺服器端的記憶體分成三塊,各自回答不同的問題:
- 基礎佔用。伺服器一啟動就佔著的那一塊,1.0 之後又變多了:海上據點帶來了游泳與飛行帕魯的尋路計算,天空島和世界樹是額外的載入區域。這是底。
- 線上玩家。每個人的視距載入與探索範圍。人下線後這一塊會回落一部分,但不是全部。
- 世界裡累積的東西。據點、建築、工作中的帕魯、地上的掉落物,玩家下線後它們照樣被模擬。這一塊會跟著世界的年紀長大:退坑的人不會把據點帶走。
前兩塊決定一整個晚上需要多少記憶體;第三塊,再加上引擎沒有還回來的部分,決定多久重啟一次才划算。
怎麼看自己的伺服器
| 訊號 | 怎麼看 |
|---|---|
| 重啟前一刻的記憶體,離機器的上限還有多遠 | top / htop 裡看伺服器端程式的 RES;Windows 看工作管理員 |
| 卡頓隨執行時間加重,重啟後就消失 | 重啟本身就是測試:重啟後變好 = 累積的負載,重啟也沒變好 = 機器不夠或是線路 |
| 程式無聲消失,全員同時斷線 | Linux 上 dmesg 裡有核心因記憶體不足砍掉程式(OOM killer)的紀錄 |
重啟後沒有任何改善,就往別處找:要嘛機器本來就不夠大,要嘛大家感覺到的根本不是伺服器而是線路。從誰在卡一路問到伺服器自己的 FPS,順序寫在伺服器很卡:先分清楚是哪一種。
記憶體不足被砍掉的那一種最傷:程式被核心砍掉的那一刻可能正在寫存檔,寫到一半的 Level.sav 要到下次啟動才會暴露出來。這就是為什麼記憶體要和備份放在一起看。
哪些設定會改變它佔多少記憶體
下面幾項全都在 PalWorldSettings.ini 那一行裡(怎麼改才安全見世界設定詳解):
| 設定 | 預設 | 建議 | 為什麼 |
|---|---|---|---|
bEnableInvaderEnemy | True | 沒人在意襲擊就設 False | 每次據點襲擊都會一口氣生成好幾波額外的 AI 和尋路計算,而且多半發生在沒人上線的時候。關掉只停掉腳本觸發的襲擊,野生帕魯、PvP 和 Boss 都不受影響 |
BaseCampWorkerMaxNum | 15 | 保持預設 | 每隻工作帕魯都在跑自己的行為模擬,據點多的伺服器把它調到 50 是最快把單核心吃滿的方式 |
DropItemAliveMaxHours | 1.0 | 0.5 | 地上無主掉落物的存活時長(小時)。縮短一半,實體回收得更快 |
AutoSaveSpan | 30 | 保持預設,最多放寬到 60 | 自動存檔間隔,單位是秒。間隔越短寫入越頻繁,硬碟慢的機器每次存檔都會頓一下;但別超過 60 秒,當機時損失的進度就是這個間隔 |
另外有幾件事不要做:不要關掉 bIsUseBackupSaveData(出事那天它是一條退路,不是記憶體負擔);不要把 ServerReplicatePawnCullDistance 調到 5000 以下(這是官方下限,再低玩家看到的是站著不動的帕魯);也不要在同一台機器上跑兩個《幻獸帕魯》伺服器端。
多久重啟一次
這個間隔沒辦法從規格表上讀出來。它取決於你的世界吃掉餘裕有多快,而那要看蓋了多少東西、襲擊開沒開、是不是全天都有人在線上。先從每天一次開始,再照實際量到的結果調整:
| 重啟前一刻 | 怎麼做 |
|---|---|
| 還剩很多餘裕 | 每天挑個安靜的時段重啟一次就夠 |
| 剩不到兩成 | 先關掉襲擊,再縮短間隔或加記憶體 |
| 兩次重啟之間程式就被砍掉了 | 立刻縮短間隔,並確認最後一份存檔讀得回來 |
對固定一起玩的隊伍,實際的答案就是每天在沒人玩的時段重啟一次。全天都有人在的公開伺服器,才可能需要更頻繁。
先公告、再倒數、存完檔才停
用 kill、systemctl kill 或直接按電源把它關掉,等於每天自製一次當機:自動存檔間隔內的進度直接消失,運氣差一點還會撞上正在寫入,留下寫到一半的 Level.sav——而它要到下次啟動才會暴露。
正確的停法是四步,全服公告 → 倒數計時 → 強制存檔 → 停止,四步都在官方 REST 介面裡。先在 PalWorldSettings.ini 裡開介面,並且只給本機用:
RESTAPIEnabled=True
RESTAPIPort=8212
AdminPassword="一個夠長的密碼"
介面用 HTTP Basic 認證,使用者名稱固定是 admin,密碼就是 AdminPassword。官方文件明確說過它不是設計來直接面向網際網路的,所以防火牆不要放行 8212。RCON 已被官方停止支援,別再往它上面寫新腳本;完整的端點清單在 REST API 管理。
PW='一個夠長的密碼'
API='http://127.0.0.1:8212/v1/api'

# 先把世界寫到硬碟上
curl -s -u "admin:$PW" -X POST "$API/save" -d ''

# 公告和倒數由介面代勞
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":60,"message":"Server is going down in 60 seconds"}'
message 不是聊天欄裡一閃而過、捲上去就沒了的一行,而是橫在每個玩家畫面正中央的一條橫幅:
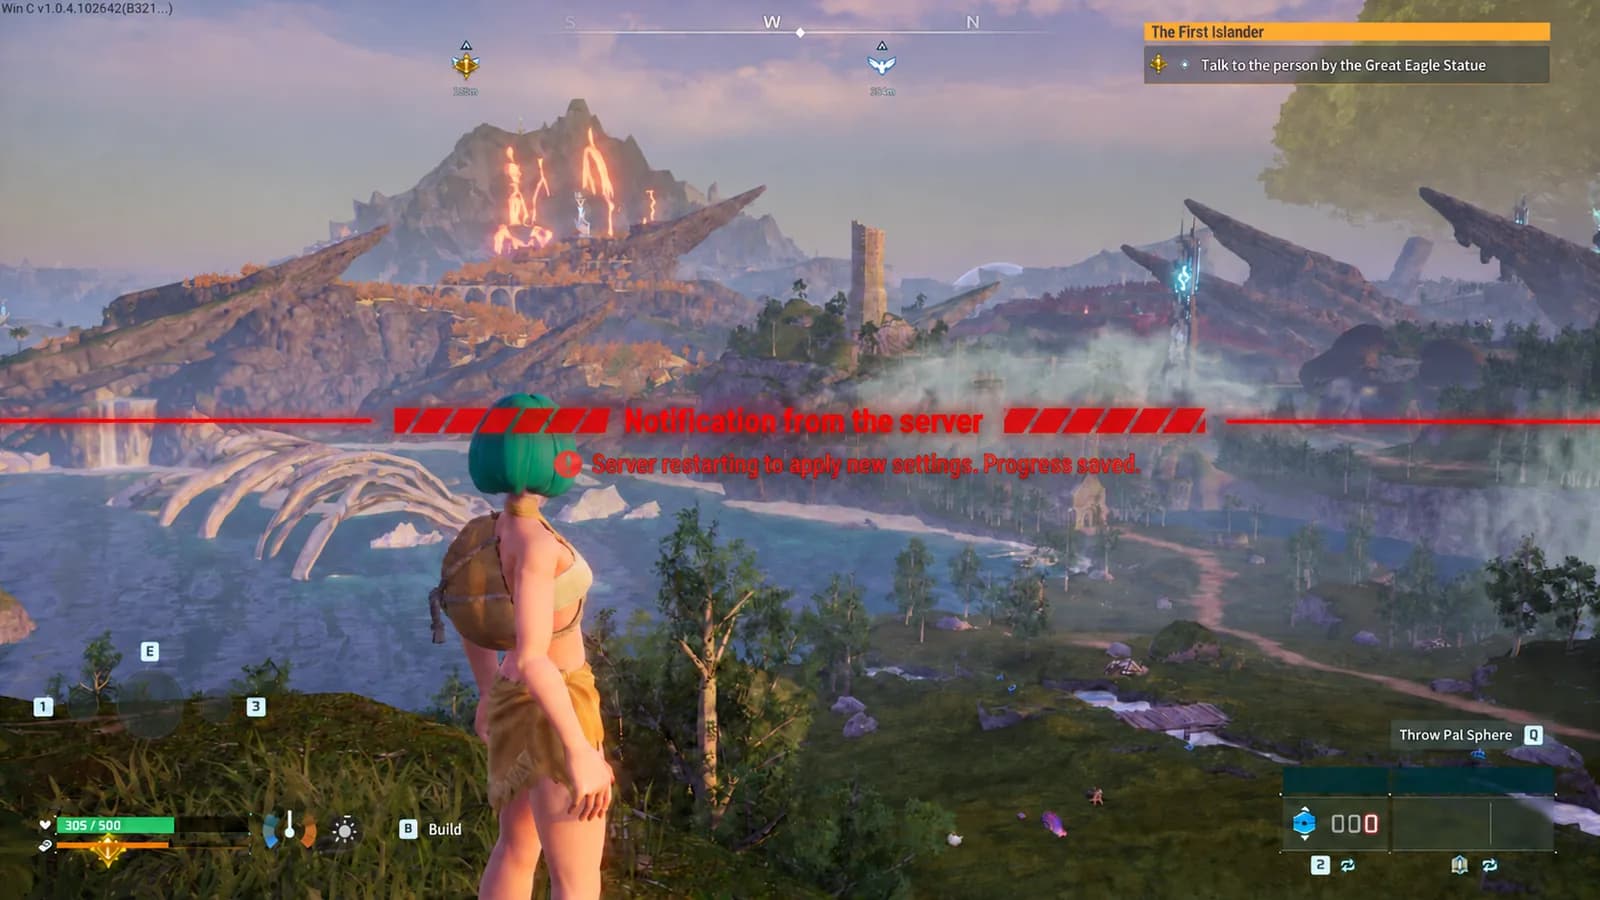
/stop 是不預告、立刻切斷的那個,日常運作不要用它;/shutdown 會等滿你給的秒數,再照正常流程關閉。存檔要排在前面,是因為官方文件沒有說明關機時會不會自己存檔。
而 systemd 那一節的陷阱在這裡剛好合上:/shutdown 關掉的程式是正常結束,Restart=on-failure 不會把它重新啟動。如果目的是重啟,就讓介面只負責存檔和公告,最後一行交給 sudo systemctl restart palworld;如果目的真的是停機(維護、搬家、整整一週沒人玩),/shutdown 本身就夠了。沒分清這兩者,是「凌晨四點停了就再也沒起來」最常見的成因。
每日重啟寫成一支腳本
#!/bin/bash
# /home/palserver/restart.sh:公告、存檔、重啟
PW='一個夠長的密碼'
API='http://127.0.0.1:8212/v1/api'

curl -s -u "admin:$PW" -X POST "$API/announce" \
     -H 'Content-Type: application/json' \
     -d '{"message":"Server restarts in 5 minutes for maintenance"}'
sleep 240
curl -s -u "admin:$PW" -X POST "$API/announce" \
     -H 'Content-Type: application/json' \
     -d '{"message":"Saving and restarting in 60 seconds"}'
sleep 60
curl -s -u "admin:$PW" -X POST "$API/save" -d ''
sleep 10
sudo systemctl restart palworld
腳本裡有管理員密碼,先 chmod 700。掛到 cron,每天凌晨四點:
0 4 * * * /home/palserver/restart.sh >> /home/palserver/restart.log 2>&1
想全部留在 systemd 裡的話,用 timer 也可以:
# /etc/systemd/system/palworld-restart.timer
[Unit]
Description=Restart Palworld daily

[Timer]
OnCalendar=*-*-* 04:00:00

[Install]
WantedBy=timers.target
同名的 palworld-restart.service(Type=oneshot)去呼叫這支腳本,再用 sudo systemctl enable --now palworld-restart.timer 啟用,下一次執行時刻用 systemctl list-timers 看。不要加 Persistent=true。那個選項是替機器關機期間錯過的排程在開機後補跑一次,而一台兩分鐘前才開起來的伺服器沒有理由再重啟。時刻挑沒人上線的時段,並避開備份在跑的時段。
Windows 上思路完全一樣:PowerShell 裡用 Invoke-RestMethod 依序呼叫 announce 和 save,再 Stop-Process 掉 PalServer-Win64-Shipping 並重新啟動 PalServer.exe,然後交給「工作排程器」每天定時跑。
反正每天都要停一次,這一停就是檢查新版本最省事的時機。版本檢查怎麼接進去、前面那份非留不可的備份,以及新版本讀不進世界時怎麼辦,都在更新教學:版本不符與不掉存檔的順序。
它掉了你怎麼第一時間知道
預設的監控是「玩家會告訴你」,而這個通知的形式是週五晚上十點五個人在等。有三種更便宜的做法。
一行狀態。systemctl is-active palworld 只會吐 active 或 failed。要看原因,就從當天的紀錄裡撈結束事件。
systemctl is-active palworld
journalctl -u palworld --since today | grep -i "main process exited"
連接埠。遊戲用的是 UDP 8211,瀏覽器打不開也就驗不了,要看實際有沒有在聽,用 ss -lunp | grep 8211。
一分鐘的心跳。本機 cron 每分鐘打一次 /metrics,失敗就往你真的會看的地方送一行。cron 拿不到你在 shell 裡設的 PW,所以密碼寫進一支小腳本,crontab 那行只負責呼叫它。
#!/bin/bash
# /home/palserver/heartbeat.sh:cron 每分鐘呼叫一次
PW='一個夠長的密碼'
curl -sf -m 10 -u "admin:$PW" http://127.0.0.1:8212/v1/api/metrics >/dev/null || /home/palserver/alert.sh
加上 -m 10,活著卻不回應的伺服器也會被當成掛了。腳本裡有管理員密碼,先用 chmod 700 /home/palserver/heartbeat.sh 讓別人讀不到,再掛進 cron:
* * * * * /home/palserver/heartbeat.sh
千萬別為了讓外部監控服務探得到就把 8212 對外開放,那等於拿整台伺服器的管理權去換一個監控。心跳留在機器內部跑,往外送的只有那一行通知。
自動暫停指的兩件事
有時候問題剛好相反。隔一天上線,據點一團亂:一半的帕魯餓著,兩隻生病,箱子裡堆滿了沒人要的礦石。這段時間沒有任何人上線,世界卻照樣在跑。專用伺服器在最後一個人離線之後不會進入休息,而是照滿員時的同一個節奏繼續算整個世界;這讓它隨時都能進來,也讓它在沒人進來的每一個時段照樣變老。如果你們是從遊戲內開房換過來的,那邊一關遊戲世界就停了,習慣就是在這裡對不上(兩種方式各把世界放在哪,寫在《幻獸帕魯》連線方式比較)。
講到這件事,被推薦的通常就是「自動暫停」,而這個說法同時指兩種不同的功能。停的是計費:沒人上線的那一段不計費,世界通常也會跟著停,但這個功能主打的是價格。停的是世界:遊戲裡的時間不再前進,帕魯不吃東西,作物不長,襲擊也不會來。要分清楚對方賣的是哪一種,問兩個問題就夠了:暫停期間世界會不會前進,以及到能重新開玩要等多久。
自動暫停實際上是怎麼做到的
市面上的自動暫停,多半是用兩個作業系統訊號把遊戲程式凍住:
kill -STOP <pid>   # 就地凍住
kill -CONT <pid>   # 從原地接著跑
SIGSTOP 不是《幻獸帕魯》的指令,遊戲根本不知道發生過這件事。核心只是不再排 CPU 給它,記憶體、開著的檔案、UDP 連接埠都還握在手上;收到 SIGCONT 之後,它從被凍住的那一道指令接著往下跑。
| 凍住 | 已停止 | 執行中 | |
|---|---|---|---|
| 遊戲程式 | 還在,只是不執行 | 沒了 | 執行中 |
| 記憶體 | 照樣佔著 | 釋放 | 佔用中 |
| 世界時間 | 停住 | 停住 | 前進 |
| 回來要多久 | 幾秒 | 一次啟動加載入世界 | — |
這兩行要用得安全,旁邊還得先搭好三件事。凍之前先強制存檔:SIGSTOP 攔不住,還沒落到硬碟的東西就留在記憶體裡,這時候要是斷電,那一段就沒了。得有東西盯著網路:凍住的程式不知道有人來了,得另外有一支用 root 跑的程式側錄封包,看到有人連進來就送 SIGCONT。還得有東西讓它留在列表上:伺服器發給遊戲後台的心跳也跟著停了,凍住的伺服器會從社群伺服器列表消失,除非有別的東西冒充它繼續跟後台通訊。
這幾件都不是 Pocketpair 提供的功能:官方 REST API 有 /save、/shutdown、/stop、/announce、踢人和封鎖,沒有暫停。放在自己家裡的機器上,這是划算的交換,因為那邊的目的是電費;但在一台付錢請別人維運的伺服器上,你是為了一個本來就有別條路可以拿到的結果,把這三個會出狀況的零件一起買回來。
更簡單的版本:直接關掉
大家要「暫停」,想要的幾乎都是我們沒在玩的時候世界也別跑。關掉伺服器就是這件事:世界落到硬碟上,沒有東西在執行,遊戲時間也就無從前進,下次開機從那份存檔接著玩。安全的做法就是上一節那組先存檔、再 /shutdown。代價也沒什麼好遮的:回來要等一次啟動加載入世界,不是一秒。如果你們是晚上約好一起玩,先到的人開起來、順手去倒杯水就差不多了。
把「關掉」那一半自動化
如果想讓它自己跑,要自動化的是關掉那一半,不是凍住那一半:一個定時器每 5 分鐘問一次伺服器現在幾個人。
#!/bin/bash
set -o pipefail
PW='一個夠長的密碼'
API='http://127.0.0.1:8212/v1/api'
STATE=/var/lib/palworld-empty-rounds
MAX=6   # 6 次 x 5 分鐘 = 30 分鐘沒人

n=$(curl -sf -u "admin:$PW" "$API/metrics" | jq -r '.currentplayernum') || exit 0
case "$n" in ''|*[!0-9]*) exit 0 ;; esac   # 不是數字就什麼都不做
[ "$n" -gt 0 ] && { rm -f "$STATE"; exit 0; }

rounds=$(( $(cat "$STATE" 2>/dev/null || echo 0) + 1 ))
echo "$rounds" > "$STATE"
[ "$rounds" -lt "$MAX" ] && exit 0

curl -s -u "admin:$PW" -X POST "$API/save" -d ''
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":10,"message":"目前沒有玩家在線上,伺服器即將關閉"}'
rm -f "$STATE"
陷阱在前兩道檢查。查不到不等於沒有人,可是管線回報的是 jq 的結束碼,不是 curl 的,而 jq 對一個掛掉的端點會回 null 然後正常結束。少了 pipefail 和那行數字檢查,null 就變成「不大於 0」,於是連接埠打個嗝就能把一台十個人在玩的伺服器關掉。計數放在檔案裡,重開機才不會留下一個數到一半的倒數。
難的那一半是怎麼開回來。這裡沒有任何東西能把伺服器叫起來,因為關掉的機器根本沒有東西在聽你的請求。關掉是一行 cron,開起來是得有人做的一個判斷——凍住那條路之所以存在,就是為了這個。
你可能兩種都不需要
如果真正困擾你的不是「世界跑了」這整件事,而是其中一部分,設定檔可以直接處理掉,而且跟暫停不一樣,這些在你正在玩的時候也生效:PalStomachDecreaceRate 調慢帕魯變餓的速度(拼錯是遊戲那邊的事),bEnableInvaderEnemy 讓沒人守的據點不會被襲擊,WorkSpeedRate 調慢你不在的時候據點的產出。
家用電腦有兩道過不去的上限
停電。跳一次電就是一次 kill -9,而且有機會正好撞在寫存檔的那一秒。UPS 買到的是幾分鐘,這幾分鐘要花在「斷電時照順序關機」才有意義——也就是要把 UPS 的監控程式接到上面那套停機順序上。至於電回來以後機器會不會自己開,那不是作業系統的設定,是 BIOS 裡的電源回復選項。跟重開機一樣,這件事也得真的把插頭拔一次才算驗過。
浮動 IP。家用線路的對外 IP 說變就變,一變,朋友存的那串 位址:連接埠 全部作廢。DDNS 可以讓一個網域名稱跟著跑,但《幻獸帕魯》用戶端存下來的是你當初打進去的字串,所以還是要全員重新填一次。再疊上路由器重開、上傳頻寬、電信端的位址共用,排查就會拉長,順序整理在連不上排查。
這兩件事都不是「設定調得更好」就能翻過去的。家用電腦撐幾天沒問題,要無人值守撐幾個月,每次卡住的都是它們。
常見問題
幻獸帕魯伺服器要怎麼做到 24 小時不關機?
把三件事分開做:enable systemd 單元,讓它開機自動啟動;單元裡寫 Restart=on-failure,讓它當機後自動重啟;再用 timer 或 cron 排一天一次的定時重啟。三件各擋一種狀況,只做其中一件,另外兩種狀況發生時它一樣是關著的。
伺服器當機後可以自動重啟嗎?
可以。單元的 [Service] 段寫上 Restart=on-failure 和 RestartSec=10,當機或因記憶體不足被砍掉之後,10 秒會重新啟動。[Unit] 段再加上 StartLimitIntervalSec=600 和 StartLimitBurst=5,每次都死在同一個原因上的伺服器就不會無限循環,10 分鐘內失敗 5 次就停下來。如果一天觸發好幾次,該查的是每次當機前一刻的記憶體和紀錄,而不是重啟設定。
自動重啟設好了,伺服器卻沒回來,要看什麼?
先看 systemctl status palworld。出現「start request repeated too quickly」表示 10 分鐘內失敗了 5 次、systemd 放棄了,真正的原因在紀錄裡,修好之後用 sudo systemctl reset-failed palworld 清掉計數再啟動。狀態一直停在 activating (auto-restart) 的話,是少了 StartLimit 那兩行,正在無限重試。沒有錯誤只是安靜地 inactive,多半是正常結束,on-failure 本來就不會碰它——把腳本最後一行改成 systemctl restart 就好。
幻獸帕魯伺服器為什麼記憶體越用越多?
主要是因為有人在玩的時候,世界裡裝的東西變多了:玩家探索過的範圍,以及玩家下線後照樣被模擬的據點、工作中的帕魯和掉落物。我們一台每天重啟的伺服器上,一般的一天漲 0.5–1.5 GB,冷清的一天幾乎不動,十天裡每天的峰值都在 3.3–4.5 GB 之間,沒有一天比一天高。每日重啟每晚把它拉回低點。
幻獸帕魯伺服器多久重啟一次合適?
從每天挑個安靜的時段重啟一次開始。判據是重啟前一刻還剩多少餘裕:少於兩成,就先關掉襲擊,再縮短間隔或加記憶體。
加記憶體能解決幻獸帕魯伺服器當機嗎?
只有在峰值時真的把記憶體用光,加記憶體才有用。看每日重啟前一刻的記憶體:峰值還有餘裕、伺服器卻照樣當機,加記憶體不會改變什麼,原因去紀錄或 dmesg 裡找;峰值已經頂到上限,加記憶體正是解法。
自動暫停是《幻獸帕魯》內建的功能嗎?
不是。專用伺服器沒有暫停指令,官方 REST API 也沒有對應端點。所有掛著自動暫停名字的做法都是在遊戲外面完成的:要嘛用作業系統訊號把遊戲程式凍住,要嘛關掉伺服器、要玩的時候再開。
把伺服器停掉,帕魯就不會餓了嗎?
停著的期間是這樣,世界裡沒有任何東西會前進,肚子餓也一樣。但它不會改變你正在玩的那段時間。如果你在意的是每次回來餵食箱都見底,PalStomachDecreaceRate 不用停掉任何東西就能解決。
用家裡的電腦 24 小時開伺服器可以嗎?
撐幾天可以。時間拉長就會卡在停電和浮動 IP:停電是沒有預告的強制關閉,可能把存檔弄壞;對外 IP 一變,大家存的連線位址全部失效。兩件都不是設定能解決的,要長期常駐就需要一台電源和線路有人在維護的機器。
這三件事在託管上分別在哪
把上面這些逐條搬到託管上,會是這樣。開機自動啟動根本不再是一個步驟,機器和遊戲程式是一起託管的。程式當機由系統自動重新啟動。每日定時重新啟動在會員中心的我的伺服器進去的伺服器詳情頁上,就是一個開關加一個時刻;時間快到時,伺服器先在遊戲裡發全服公告、走完倒數計時、強制存檔,之後才重新啟動。手動停機和開機是同一頁上的按鈕,背後跑的也是同一套公告 → 存檔 → 關機,所以「這週先關著」是一個習慣,不是賭一把。備份按排程跑(一份完整備份包含什麼),FPS 和線上人數每分鐘記錄一次,停掉的那一段在圖上就是一段斷掉的線,不必去翻紀錄。
這裡沒有的是自動閒置關機:沒有東西會盯著線上人數替你關掉。KeepWorlds 的《幻獸帕魯》專用伺服器託管上,這幾項就長這樣。就算你選擇自己架,要確認的清單也一樣:一次 enable、一行 Restart、一個先存檔再重啟的每日排程,再加一個知道它掉了的方法。